Sua IA sabe escrever código. Quem controla o que ela pode fazer?
Agent harnesses, skills e sandboxes ajudam a organizar o trabalho da IA. Entenda o que cada camada resolve e como avaliar agentes no seu repositório.
As vozes dependem do navegador e do dispositivo; algumas precisam de internet. Blocos de código não são narrados.
Leitura estimada: 10 minutos. Referências consultadas em 26 de outubro de 2026.
Você pede um ajuste pequeno. O agente abre o repositório, cria uma abstração, adiciona uma dependência, mexe em um arquivo que estava quietinho e termina com aquela confiança de quem acabou de salvar a engenharia de software.
Aí você abre o diff.
O problema inicial até pode estar resolvido. Só que agora existe uma segunda tarefa: descobrir por que uma correção de formulário virou uma reforma na casa inteira.
Esse é um cenário ilustrativo, mas ajuda a apresentar uma pergunta que considero muito mais útil do que “qual IA programa melhor?”: que ambiente estamos oferecendo para essa IA trabalhar, e como verificamos o resultado?
Quando olho para integrações como as que desenvolvo na Oombe, penso em contratos de API, regras de negócio, estados intermediários e consequências. Gerar código é uma parte do serviço. Entregar uma alteração que respeite tudo isso exige método. É nessa conversa que entram agent harnesses, runtimes, skills e sandboxes.
Quatro nomes, quatro responsabilidades
Esses termos aparecem juntos, mas ajudam a responder perguntas diferentes. Para organizar a discussão, uso esta divisão prática:
| Camada | Pergunta que ajuda a responder |
|---|---|
| Modelo | Como interpretar a tarefa e escolher o próximo passo? |
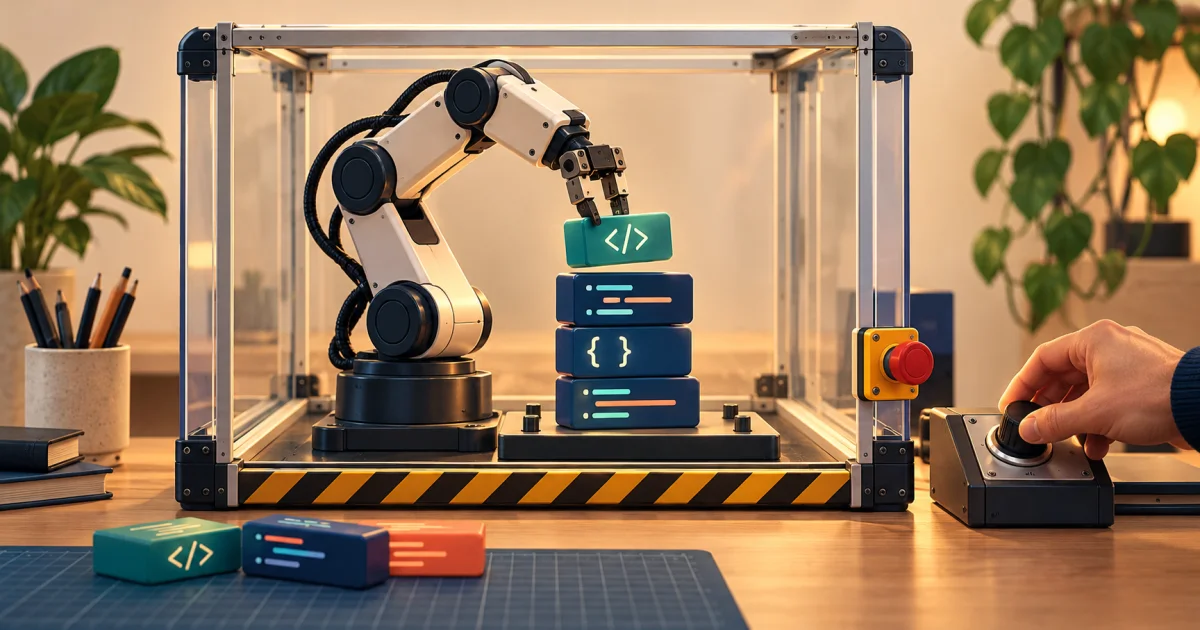
| Harness | Como coordenar ferramentas, contexto, estado e continuidade do trabalho? |
| Skill | Que procedimento reutilizável deve orientar esta tarefa? |
| Sandbox e políticas | A quais recursos a execução realmente tem acesso? |
Os produtos podem combinar essas funções. Portanto, a tabela é uma forma de analisar a arquitetura, não uma classificação universal de ferramentas.
A especificação de Agent Skills define um diretório com SKILL.md e recursos opcionais. Descrições, instruções e arquivos podem ser carregados progressivamente. Essa organização permite entregar conhecimento conforme a necessidade, sem despejar um manual inteiro no contexto inicial.
Uma skill pode ensinar a revisar uma integração. O ambiente de execução precisa fornecer os meios para consultar arquivos, executar verificações e apresentar evidências. Cada peça tem trabalho próprio.
A discussão amadureceu, mas não nasceu em 2026
A Anthropic apresentou Agent Skills em outubro de 2025, com a publicação do padrão aberto registrada em dezembro daquele ano. Já havia, portanto, uma tentativa concreta de transformar procedimentos em recursos reutilizáveis.
Em 2026, a conversa ganha exemplos que podemos abrir, comparar e experimentar. Isso é mais interessante do que anunciar uma revolução a cada nome novo.
Também evitaria decretar “o fim dos wrappers”. Uma chamada de modelo pode ser suficiente para uma tarefa bem delimitada. A orientação da Anthropic sobre construção de agentes recomenda começar simples e acrescentar complexidade quando ela melhora o resultado. Um fluxo previsível continua sendo uma escolha válida de engenharia.
Se sua aplicação classifica um texto e retorna um campo, uma equipe de agentes talvez acrescente mais manutenção do que valor. Vale perguntar qual decisão realmente exige autonomia.
Skills úteis guardam conhecimento do trabalho
Imagine uma skill para revisar alterações em uma integração com marketplace. Eu começaria pelas perguntas que um integrador experiente faria: a mudança respeita o contrato da API? Como identifica a conta correta? O que acontece se a resposta vier incompleta? Existe alguma dependência que já resolve essa necessidade?
Depois, definiria as evidências esperadas: casos analisados, verificações executadas, limitações encontradas e decisões que exigem contexto do negócio. Uma instrução como “produza código profissional” oferece pouca orientação sobre essas escolhas.
O valor está em tornar o procedimento explícito e revisável. Se a equipe descobre uma nova condição de erro, pode melhorar a skill e avaliar se a próxima execução lida melhor com ela. Isso transforma aprendizado em manutenção concreta.
Matt Pocock publica uma coleção de skills pequenas e combináveis, voltadas a problemas de requisitos, feedback e arquitetura. Addy Osmani organiza práticas ao longo do ciclo de desenvolvimento e inclui verificação, revisão e entrega. São referências de autores, com escolhas próprias, para estudar e adaptar.
Eu evitaria instalar uma coleção inteira por impulso. Escolheria uma dor recorrente, leria os arquivos envolvidos e acompanharia o efeito. O procedimento deve ajudar a equipe a pensar melhor, inclusive quando a decisão correta é manter uma implementação simples.
Uma instrução não concede nem retira permissão
Escrever “não leia segredos” em um arquivo é uma orientação. Restringir a leitura desses segredos exige uma configuração que continue funcionando quando o agente erra.
A arquitetura do NVIDIA OpenShell ilustra essa separação: um supervisor confiável aplica políticas a recursos e conexões, fora do ambiente do agente. O projeto documenta mediação de rede e entrega de credenciais somente em destinos aprovados.
A implicação prática é perguntar o que permanece acessível mesmo depois de uma instrução ruim. Se o processo pode ler todas as pastas do usuário, a frase “trabalhe apenas neste projeto” não equivale a uma permissão de sistema limitada àquele diretório.
Eu desenharia o ambiente começando pelo necessário: código do projeto, ferramentas de desenvolvimento e dados de teste. Acrescentaria acessos específicos conforme a tarefa. Credenciais de produção merecem uma decisão própria; não deveriam aparecer por herança acidental do terminal.
Também separaria a capacidade de propor uma mudança da capacidade de aplicá-la em um serviço externo. Revisar um arquivo e publicar uma alteração têm efeitos diferentes. O sistema deve representar essa diferença de maneira verificável.
Essa preocupação conversa com o que já discuti sobre segurança frágil por trás de uma interface bonita: confiança visual e confiança operacional precisam de evidências distintas.
DeepSeek Harness: arquitetura interessante, aviso explícito
O DeepSeek Harness oficial utiliza uma arquitetura de plugins apoiada no Cordis. Seu README o apresenta como developer preview, sujeito a mudanças incompatíveis. É um projeto real da DeepSeek AI, não apenas um apelido usado pela comunidade.
A ressalva decisiva está no SAFETY.md: o projeto declara não ter passado por auditoria de segurança e orienta que não seja tratado como seguro ou pronto para produção. Também esclarece que seus controles não garantem isolamento.
Eu levaria esse aviso a sério na escolha do ambiente de avaliação. Um laboratório descartável permite aprender sobre a arquitetura sem transformar entusiasmo em dependência operacional. O resultado de uma demonstração deve ser interpretado dentro das condições em que ela foi executada.
O nome “harness” descreve uma função no sistema. Para decidir onde usar um produto específico, ainda precisamos examinar maturidade, permissões, manutenção e limites documentados.
O trabalho precisa sobreviver ao fim da conversa
Há outra dimensão menos cinematográfica: continuidade. Uma tarefa pode atravessar sessões, interrupções ou trocas de contexto. O próximo agente precisa entender o que foi feito e o que continua pendente.
No artigo Effective harnesses for long-running agents, publicado em novembro de 2025, a Anthropic descreve uma combinação de preparação do ambiente, progresso incremental, histórico Git e registros de andamento. O objetivo é ajudar sessões posteriores a retomar trabalho verificável.
Na prática, eu pediria um registro curto que respondesse: qual era a tarefa, quais decisões foram tomadas, quais verificações passaram e qual é o próximo passo. Um texto enorme pode apenas transferir a confusão para outro arquivo.
Também trataria “concluído” como um estado sustentado por evidências. Se o comportamento esperado depende de uma interação na interface, compilar o projeto não encerra automaticamente a verificação. Se depende de uma integração, uma resposta simulada precisa cobrir a condição relevante.
O melhor modelo pode depender do ambiente
Um estudo publicado em outubro de 2026 avaliou 66 configurações e encontrou mudanças no desempenho relativo de modelos conforme o harness e a tarefa. É evidência restrita aos benchmarks estudados; não estabelece um vencedor universal nem prevê automaticamente o resultado do seu projeto.
A lição que extraio é operacional: quando uma experiência piora, vale investigar ferramentas, mensagens de erro, contexto disponível e critérios de parada, além do modelo escolhido.
Trocar de provedor pode ajudar. Também pode esconder um problema de integração que reaparecerá depois. Registrar a configuração completa torna a comparação mais útil do que guardar apenas o nome comercial da IA.
Como eu avaliaria isso em um projeto Laravel
Escolheria um laboratório pequeno: melhorar o tratamento de um webhook fictício, preservando o comportamento diante de eventos repetidos. Usaria dados sintéticos e nenhum acesso a contas reais. O cenário é uma proposta de avaliação, não um resultado já obtido na Oombe.
Primeiro, definiria o que precisa continuar verdadeiro: um mesmo evento não pode produzir duas alterações equivalentes; uma falha precisa ficar identificável; outro cliente não pode ser afetado. Prepararia verificações independentes antes das execuções.
Compararia três condições, mantendo modelo, tarefa e orçamento equivalentes:
- Orientação básica: descrição da tarefa e acesso ao projeto de teste.
- Procedimento reutilizável: a mesma tarefa, acompanhada de uma skill com contexto de domínio e evidências esperadas.
- Procedimento e controles externos: a mesma skill, com escopo de arquivos, rede e ações definido pelo ambiente.
Todos os grupos continuariam em um laboratório seguro. A comparação não exige expor uma máquina pessoal para criar um “antes” dramático.
Eu repetiria os casos e observaria resultados, alterações fora do objetivo, dependências adicionadas, tempo de revisão e custo. Também registraria tentativas bloqueadas: elas ajudam a entender o que o ambiente impediu, mesmo quando o código final parece semelhante.
Uma condição pode custar mais e reduzir trabalho de correção. Outra pode ser rápida, mas exigir revisão extensa. A decisão depende da tarefa e do impacto dos erros. Não partiria de uma porcentagem de economia prometida.
Guardaria versões das skills e dos testes. Se tudo muda entre duas rodadas, fica difícil saber qual alteração explicou a diferença. Essa disciplina produz um aprendizado que a equipe consegue repetir.
Um bom começo cabe em uma tarefa pequena
Para quem quer aplicar essas ideias, eu começaria com uma rotina recorrente e uma definição clara de sucesso. Documentaria o procedimento, limitaria o ambiente e revisaria algumas execuções completas. Depois, ajustaria o que realmente atrapalhou.
Se a skill ficou longa demais, procuraria quais decisões ela tenta antecipar sem necessidade. Se o agente pede acesso amplo, examinaria qual recurso específico falta. Se ele declara sucesso cedo, melhoraria a evidência exigida para encerrar a tarefa.
A autonomia pode crescer junto com o conhecimento sobre o comportamento do sistema. No meu trabalho, esse é um critério mais convincente do que a empolgação de um vídeo: saber explicar o que a automação faz, onde pode falhar e como alguém assume o controle quando necessário.
Fontes
- Agent Skills — especificação.
- Anthropic — apresentação de Agent Skills.
- Anthropic — Building effective agents.
- Matt Pocock — Skills for Real Engineers.
- Addy Osmani — Agent Skills.
- NVIDIA OpenShell — arquitetura.
- DeepSeek Harness — projeto oficial e aviso de segurança.
- Anthropic — Effective harnesses for long-running agents.
- Finding the Right Fit: Model-Harness Interactions across Agent Tasks.