IA local y LGPD: cómo controlar datos, accesos y operación
Alojar el modelo es una parte del proyecto. Aprende a evaluar datos, permisos, aislamiento, costes y operación para implantar IA local con criterios verificables.
Las voces dependen del navegador y del dispositivo; algunas necesitan conexión a internet. Los bloques de código no se leen en voz alta.
Tiempo estimado de lectura: 10 minutos.
«Vamos a ejecutar la IA en nuestro servidor y resolver la LGPD».
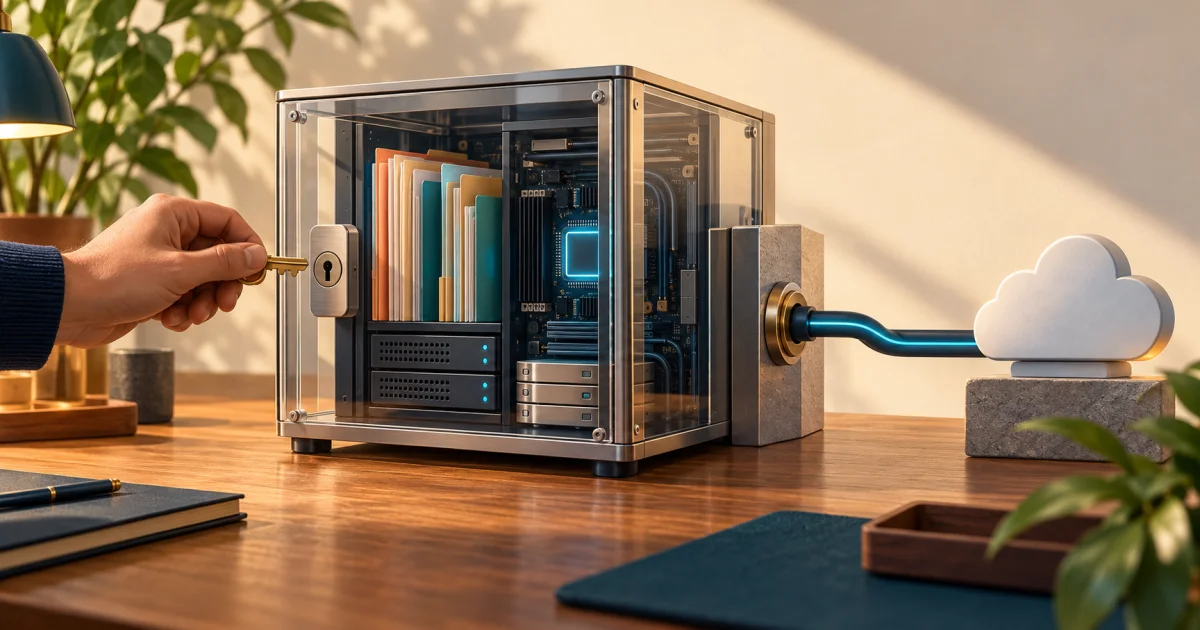
La frase parece un plan completo. En la práctica, responde una pregunta importante —dónde ejecutar el modelo— y deja otras esperando: quién accede a los documentos, qué copias existen, cómo eliminar información y quién mantiene todo funcionando.
Me gusta la idea de tener más control sobre la tecnología. Sin embargo, al trabajar con integraciones y sistemas, he aprendido a cuestionar las soluciones que prometen cerrar una discusión entera con una única decisión de infraestructura.
Un ejemplo cercano es el proyecto de generador de currículos pensado para Pinheiral Digital. La intención era permitir que el ciudadano preparara su currículo y descargara el archivo, sin conservar sus datos en el servicio. Era una decisión de diseño, no una afirmación de que la solución ya estuviera implantada o auditada.
La pregunta inicial era sencilla: ¿necesitamos guardar esta información para entregar el resultado? Con IA, conviene empezar por la misma pregunta antes de elegir la tarjeta gráfica.
Local-first, inferencia local y soberanía responden preguntas diferentes
El concepto de local-first presentado por Ink & Switch incluye autonomía sobre los datos, funcionamiento sin conexión y colaboración. Describe principios de producto y almacenamiento, no solamente el lugar donde un modelo realiza una inferencia.[1]
Una aplicación puede guardar documentos en el dispositivo y enviarlos a una API al activar una función de IA. También puede utilizar un modelo dentro de la empresa y depender de una interfaz centralizada para todas las demás funciones. Por tanto, decir «es local» exige completar la frase: ¿qué parte?
Para organizar esta conversación, utilizaría cinco preguntas:
| Dimensión | Pregunta que debemos responder |
|---|---|
| Inferencia | ¿Dónde procesa el modelo la solicitud? |
| Operación | ¿Quién administra la infraestructura y las actualizaciones? |
| Residencia de los datos | ¿Dónde están originales, índices, registros y copias de seguridad? |
| Control | ¿Quién concede acceso, modifica reglas e interrumpe el servicio? |
| Continuidad | ¿Cómo recuperamos datos y sustituimos componentes? |
En este proyecto, la soberanía debe traducirse en capacidades verificables. «Podemos exportar el archivo documental» es una respuesta más útil que un sello atractivo que diga «IA soberana».
Qué cambia la LGPD en esta decisión
La LGPD brasileña exige finalidad, necesidad, transparencia y medidas de seguridad, y establece bases legales para el tratamiento. Su artículo 33 admite transferencias internacionales bajo condiciones determinadas. La ley no impone una obligación general de alojar todos los datos personales en Brasil.[2]
La Resolución CD/ANPD nº 19/2024 regula mecanismos de transferencia internacional, incluidas cláusulas estándar y decisiones de adecuación. El texto oficial registra una rectificación de 2025. El mecanismo aplicable depende de la operación; no existe una solución contractual única para todos los casos.[3]
Mi interpretación para el diseño técnico es esta: elegir un centro de datos resuelve una parte del mapa. El proyecto todavía necesita justificar el uso de los datos, definir accesos y demostrar controles. Un equipo puede equivocarse en su propio servidor o construir un servicio externo bien gobernado.
Por eso, el análisis técnico y la evaluación jurídica deben conversar. Un documento que promete eliminación sirve de poco si nadie sabe dónde están las copias de seguridad. El tema conecta directamente con la discusión sobre Política de Privacidad y Términos de Uso: la operación debe sostener las condiciones comunicadas.
Sigue un documento hasta el final de su recorrido
Imaginemos una empresa que quiere consultar sus propios manuales mediante un asistente. El diseño inicial parece breve: entra un documento, sale una respuesta. Para evaluar privacidad, abriría esa caja y registraría cada etapa.
El archivo puede necesitar extracción de texto. Después, sus fragmentos pueden generar representaciones para búsqueda, entrar en un índice, formar parte del contexto de una pregunta y aparecer en registros de diagnóstico. Una respuesta también puede exportarse o enviarse a otra herramienta.
Son posibilidades de una arquitectura, no etapas obligatorias de todos los sistemas. El trabajo consiste en descubrir cuáles existen realmente en la implantación elegida.
| Etapa | Decisión que debe documentarse |
|---|---|
| Recepción | ¿Qué archivos se aceptan y de quién? |
| Extracción | ¿El contenido se procesa localmente o se envía a un servicio? |
| Indexación | ¿Qué fragmentos entran en el índice y con qué permisos? |
| Consulta | ¿Cómo se identifica al usuario antes de recuperar información? |
| Registro | ¿El log necesita el contenido completo o solo metadatos? |
| Finalización | ¿Cómo eliminar originales, derivados y copias previstas? |
Esta tabla suele producir preguntas mejores que «¿qué modelo es más privado?». También muestra una oportunidad de simplificación: puede que cierta información ni siquiera necesite entrar en el sistema.
Una herramienta local también requiere configuración consciente
La FAQ de Ollama distingue ejecución local y modelos en la nube, y documenta la desactivación de funciones de nube mediante OLLAMA_NO_CLOUD. Por tanto, es necesario verificar la modalidad utilizada, incluso cuando la interfaz está instalada en el propio equipo.[4]
La configuración de un componente no describe automáticamente el resto de la aplicación. Si añades extracción externa de documentos u observabilidad alojada, también debes evaluar esos recorridos. La prueba relevante sigue el flujo completo.
Por su parte, nanochat, de Andrej Karpathy, se presenta como un harness experimental para entrenar LLM, con etapas como tokenización, entrenamiento, evaluación e inferencia. Ese propósito no equivale a ofrecer una plataforma empresarial lista para utilizar.[5]
Es un recurso interesante para comprender mecanismos y experimentar. En una implantación para clientes, todavía habrá que especificar operación, identidad, disponibilidad y protección de datos. «El repositorio funciona» es un excelente hito de aprendizaje; el contrato de servicio preguntará por más cosas.
Compartir la GPU exige pensar en fronteras de acceso
La documentación de seguridad de vLLM advierte que un proceso compartido no proporciona aislamiento entre clientes mutuamente no confiables. También explica que cache_salt no debe tratarse como una frontera de seguridad.[6]
Eso importa cuando alguien propone atender a varias empresas con el mismo servicio. La decisión debe considerar cuánto aislamiento necesita cada caso, además de la memoria disponible y la velocidad.
Imagina dos clientes ficticios: Taller Azul y Taller Verde. Cada uno tiene documentos internos diferentes. Los criterios de aceptación deben exigir que un usuario de Azul no pueda recuperar contenido de Verde, verlo en registros ni recibirlo en respuestas.
Empezaría separando identidad y autorización de la decisión del modelo. El sistema determina qué documentos puede consultar el usuario antes de preparar el contexto. Pedir a la IA que «recuerde no mostrar información de otros clientes» deja la protección dependiendo de una interpretación.
Según el riesgo, la arquitectura puede necesitar instancias o entornos separados. El diseño final debe justificar sus fronteras y probarlas. Ahorrar una máquina no compensa, por definición, cualquier nivel de compartición.
Una prueba de concepto que sabe decir «no»
Para un primer experimento, usaría entre 20 y 30 documentos sintéticos: manuales inventados, procedimientos ficticios e información creada específicamente para las pruebas. No convertiría historias clínicas, contratos reales ni expedientes municipales en material improvisado de laboratorio.
Definiría dos perfiles. Uno consulta procedimientos generales; el otro también accede a documentos restringidos. Cada pregunta tendría un resultado esperado: responder con una fuente, pedir aclaraciones o rechazar la consulta por falta de información o acceso.
El conjunto incluiría preguntas con respuesta conocida, preguntas sobre información ausente e intentos de consultar material del otro perfil. También probaría un documento actualizado: ¿el asistente utiliza la nueva versión?, ¿el contenido antiguo sigue apareciendo en algún lugar?
La evaluación registraría cinco elementos: corrección de la respuesta, fuente citada, respeto de permisos, tiempo de respuesta y coste por tarea aceptada. Los criterios deben definirse antes de comparar modelos, para evitar elegir un favorito e inventar la justificación después.
Una demostración que rechaza una consulta indebida puede resultar más convincente para el cliente que otra que responde a todo con mucha soltura. La confianza también se construye en los límites.
El coste real continúa después de la descarga
Descargar los pesos de un modelo puede ser apenas el primer elemento de la factura. Para comparar alternativas, propongo estimar el coste mensual completo:
infraestructura + energía + operación + actualización + observabilidad + recuperación + tiempo de ingeniería.
Después, relaciona ese total con la cantidad de tareas completadas con una calidad aceptable. Incluye períodos de baja demanda, crecimiento, fallos y necesidades de soporte. El cálculo es un modelo de decisión; los valores deben proceder de la operación estudiada.
Una API gestionada puede ser adecuada para una demanda irregular y un equipo pequeño. Una implantación propia puede tener sentido cuando los requisitos y el volumen justifican la responsabilidad adicional. Son escenarios para comparar, no recomendaciones universales.
También conviene verificar la licencia del modelo y de sus componentes antes de ofrecer el servicio. Acceder a los pesos no responde por sí solo a todas las condiciones de uso comercial.
Para quienes trabajan con SaaS, como en mi contexto con Oombe, la pregunta útil es cuánto cuesta entregar el resultado de manera sostenible. El servidor más barato del presupuesto inicial puede exigir una operación que el equipo todavía no puede mantener.
Qué debe acordarse antes de la entrega
Organizaría la implantación en decisiones pequeñas y verificables:
- Alcance: qué tareas atiende el asistente y cuáles quedan fuera.
- Datos: qué categorías entran, por qué entran y cuáles pueden reducirse.
- Acceso: quién consulta, administra, exporta y revisa permisos.
- Ciclo de vida: cuándo actualizar, eliminar y revisar copias.
- Operación: quién responde por fallos, capacidad y actualizaciones.
- Evidencias: qué pruebas, registros y documentos demuestran lo acordado.
Cada decisión debe tener un responsable. «El equipo se ocupa de eso» parece suficiente hasta que aparece una interrupción y nadie sabe quién puede actuar.
En una pequeña empresa, este registro puede comenzar siendo sencillo. Su calidad depende de poder aplicarlo, actualizarlo y verificar resultados. Añadir complejidad sin una necesidad concreta solo produce más piezas que mantener.
Una oportunidad de servicio con una promesa honesta
Este trabajo puede convertirse en diagnóstico, prueba de concepto, implantación y acompañamiento. El entregable puede incluir un mapa de datos, criterios de aceptación, comparación de alternativas y un plan operativo.
Para ofrecerlo, prefiero una promesa verificable: «vamos a demostrar cómo controla el acceso el sistema y cómo cumple los requisitos definidos». Expresiones como «instálalo y cumple la normativa» ocultan trabajo que todavía debe realizarse.
El mismo razonamiento se aplica a sectores como salud y servicios jurídicos. Una hipótesis de uso merece una evaluación específica; el nombre del sector no permite dar por supuesta la arquitectura ni el retorno financiero.
Mi punto de partida sigue siendo aquella pregunta del generador de currículos: ¿qué necesitamos procesar y guardar realmente? Después vienen el modelo, el hardware y la forma de operar.
Controlar una IA significa poder explicar su funcionamiento, imponer límites y sostener la operación. La ubicación del servidor tiene un papel importante en esa historia. Funciona mejor cuando viene acompañada del resto del proyecto.
Fuentes y lecturas
- Ink & Switch — Local-first software, 2019.
- Presidencia de Brasil — Ley General de Protección de Datos Personales.
- ANPD — Resolución CD/ANPD nº 19/2024.
- Ollama — FAQ oficial.
- Andrej Karpathy — nanochat.
- vLLM — documentación de seguridad.
Fuentes consultadas el 26 de octubre de 2026. Los ejemplos de evaluación son propuestas de experimentos; no se atribuyen resultados de implantación al autor.