IDU: quando 10 reclamações numa rua podem pesar mais que 30 num bairro
Da pergunta que inspirou o Índice de Dor Urbana à modelagem com Haversine, densidade espacial e validação estatística: a experiência do Pinheiral Digital e uma metodologia aberta para municípios.
As vozes dependem do navegador e do dispositivo; algumas precisam de internet. Blocos de código não são narrados.
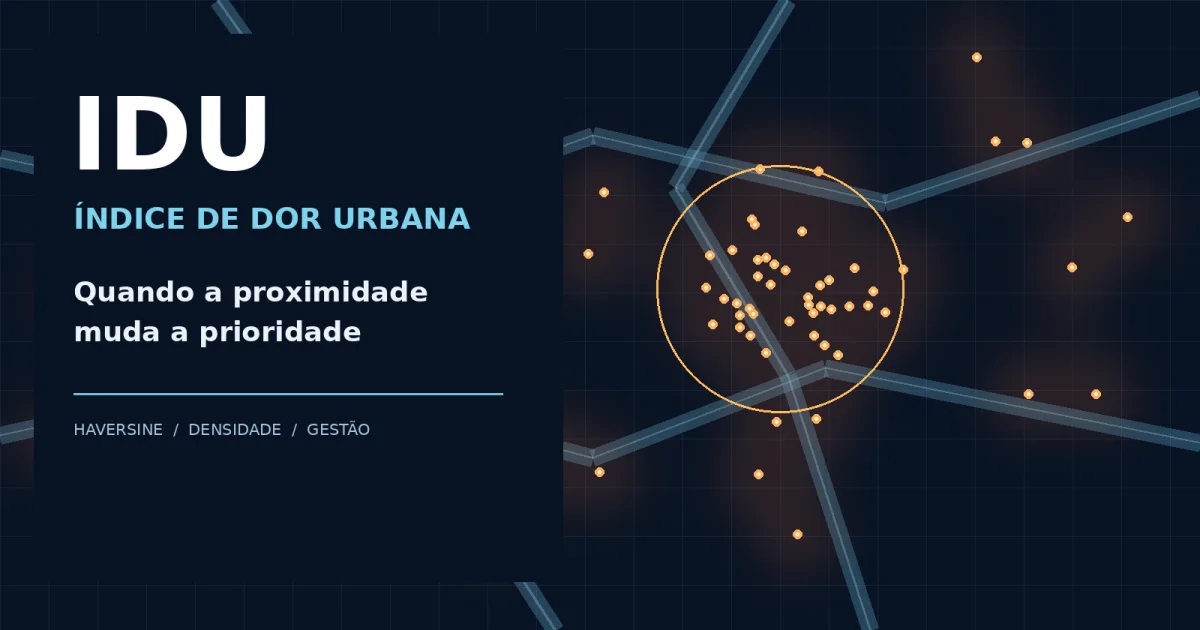
IDU: quando 10 reclamações numa rua podem pesar mais que 30 num bairro
Como uma pergunta sobre concentração territorial se transformou em uma proposta de inteligência para a gestão pública.
Dez reclamações concentradas numa única rua pesam mais do que trinta distribuídas por um bairro inteiro?
Foi essa a pergunta que orientou a concepção do Índice de Dor Urbana (IDU). A resposta não é universal: depende da gravidade, da distribuição das ocorrências, da população exposta e do objetivo da priorização. Mas a pergunta revela a insuficiência de classificar territórios somente pelo número de chamados.
A origem: um problema concreto de gestão
A experiência surgiu no trabalho de modernização da gestão municipal em Pinheiral, no Sul Fluminense (RJ), dentro do ecossistema Pinheiral Digital, que recebe demandas da população e permite acompanhá-las por localização e tema. Em fevereiro de 2026 já há registros de uso do IDU em relatórios e discussões sobre o projeto; a data exata de elaboração da primeira fórmula não está documentalmente estabelecida aqui e não deve ser confundida com a data deste artigo.
O sistema já permitia organizar demandas por bairro, eixo temático, departamento, período e município, oferecendo uma visão executiva da prestação de serviços. O IDU nasceu da percepção de que um ranking de bairros por volume absoluto pode ocultar a severidade de problemas em microterritórios. A análise e os relatórios associados ao IDU também compuseram a experiência levada ao Prêmio Sebrae Prefeito Empreendedor. Isso é contexto de aplicação e apresentação, não uma alegação de validação científica do índice.
Um exemplo simples: uma rua onde moradores registram repetidamente alagamentos pode exigir atenção focalizada, enquanto dezenas de demandas heterogêneas, espalhadas por um bairro, reclamam intervenções diferentes. Contar protocolos é útil; compreender sua relação espacial acrescenta uma camada decisória.
A distância: por que Haversine?
O sistema trabalha com coordenadas geográficas — latitude e longitude —, e a fórmula de Haversine oferece um meio transparente para estimar a distância de grande círculo entre dois pontos da superfície terrestre:
a = sen²((φ₂−φ₁)/2) + cos(φ₁)·cos(φ₂)·sen²((λ₂−λ₁)/2)
d = 2R·atan2(√a, √(1−a))
Aqui, φ representa latitude, λ longitude (ambas em radianos) e R o raio médio da Terra, aproximadamente 6.371 km. O cálculo permite avaliar se duas ocorrências estão a poucos metros uma da outra, mesmo que pertençam a divisões administrativas distintas.
Haversine não calcula, sozinho, o IDU, nem detecta automaticamente um problema estrutural. É uma função de distância usada para construir vizinhanças, medir concentração e apoiar algoritmos de agrupamento. Para deslocamentos por ruas, a distância de rede viária pode ser mais adequada do que a distância geodésica; para raios urbanos pequenos, Haversine é uma aproximação prática.
Da contagem à densidade: proposta metodológica aberta
Uma métrica inicial, com raio fixo e explicitado, é a densidade local:
D_r(x) = N_r(x) / (π · r²)
N_r(x) é o número de ocorrências num raio r do ponto x. É essencial não trocar o raio entre áreas quando se deseja compará-las diretamente. Raios distintos significam escalas de observação diferentes, não diferenças automaticamente atribuíveis ao território.
Para incorporar dimensões adicionais, uma formalização proposta para estudo e adaptação, não apresentada aqui como código auditado do sistema em produção, é:
IDU_r(x,t) = [ A_ref / (π·r²) ] · Σ (gᵢ · pᵢ · uᵢ · qᵢ)
            para ocorrências i em distância ≤ r de x e na janela t
Em que gᵢ é gravidade definida por critérios públicos; pᵢ, ponderação temática; uᵢ, urgência; qᵢ, fator temporal/recorrência sem duplicar artificialmente o mesmo incidente; e A_ref, área de referência fixa para tornar o valor adimensional. Esta forma soma as ocorrências ponderadas numa vizinhança. Uma implementação deve normalizar escalas e documentar a escolha dos pesos, sem fingir que estes sejam leis naturais.
Nos registros de elaboração do projeto aparece também uma proposta de índice ponderado de 0 a 10, combinando volume, gravidade, urgência, reincidência e concentração. Como não foi feita uma auditoria da implementação atual, as equações expostas neste texto são formulações metodológicas, e não uma certificação da versão executada em Pinheiral.
Uma simulação que qualquer pessoa pode reproduzir
Vamos isolar somente a variável espacial, mantendo gravidade, tema e janela temporal iguais. Considere duas áreas hipotéticas de análise:
| Indicador | Área A: bairro | Área B: microterritório |
|---|---|---|
| Ocorrências | 30 | 10 |
| Área observada | 3 km² | π·(0,04 km)² ≈ 0,005027 km² |
| Densidade | 10 ocorrências/km² | 1.989,4 ocorrências/km² |
| Razão em relação à área A | 1× | ≈ 198,9× |
Essa diferença expressiva é consequência das áreas de observação escolhidas: uma análise municipal não deve comparar um bairro inteiro com um círculo minúsculo e declarar, só por isso, que o segundo merece 199 vezes mais recursos. A comparação serve para mostrar por que a agregação administrativa mascara concentrações. Uma verificação adequada calcula ambos os territórios com a mesma escala espacial e complementa o resultado com exposição, criticidade e capacidade de resposta.
Outra comparação, desta vez com raio comum de 50 m, é fácil de interpretar: se dentro de uma janela padronizada são identificadas 10 demandas numa rua e apenas 2 em uma janela de outro bairro, a primeira tem densidade local cinco vezes maior. Isso não equivale a dizer que o conjunto de 30 reclamações distribuídas pelo bairro seja irrelevante.
Os números são simulados, não extraídos de chamados reais do Pinheiral Digital. Não constituem prova de desempenho preditivo do IDU.
Como validar a hipótese cientificamente
A questão verificável é: a concentração espacial acrescenta informação útil à priorização, depois de considerados volume, gravidade e população exposta?
Uma pesquisa pode utilizar dados georreferenciados, após controle de qualidade, anonimização adequada e definição de uma unidade de análise. Comparar pelo menos três modelos:
- M0 — referência: quantidade de ocorrências, tipologia e exposição populacional;
- M1 — espacial: M0 mais densidade local calculada com raio fixo;
- M2 — ampliado: M1 mais gravidade, recorrência e medidas de vulnerabilidade, se disponíveis.
A variável de desfecho precisa ser externa ao índice: por exemplo, avaliação técnica independente de criticidade, prazo até resolução de incidentes realmente graves ou evidência de repetição de falha física. Se o desfecho for uma fórmula que já inclui densidade, a avaliação será circular.
Regressão apropriada ao tipo de desfecho, análise dos resíduos, Moran’s I, indicadores locais LISA, comparação com DBSCAN e KDE podem testar a contribuição geográfica. A validação cruzada deve separar períodos e, idealmente, setores geográficos para evitar vazamento espacial entre treino e teste. Relatar incerteza, análise de sensibilidade para raios (por exemplo, 50, 100 e 200 m) e desempenho fora da amostra importa mais do que buscar um único p-valor significativo.
Uma cautela adicional: chamados não são amostra aleatória de toda a população. Acesso digital, capacidade de mobilização, duplicidades, diferenças demográficas e subnotificação podem produzir hotspots de participação, não necessariamente hotspots de dano. O indicador deve complementar, não substituir, inspeção em campo, critérios legais de emergência e escuta ativa.
O que existe e o que continua em aberto
A experiência de Pinheiral Digital é o contexto operacional dos tickets, relatórios e leitura territorial que inspiraram o IDU. A formulação matemática apresentada aqui é uma proposta aberta para detalhamento, replicação e testes. Não há nesta publicação uma avaliação experimental com base de dados pública, um repositório de código certificado ou demonstração de eficácia causal. Publicar essa distinção é parte da transparência científica.
O caminho para replicar envolve esquema mínimo de dados (identificador pseudonimizado, categoria, datas, status e coordenadas com acesso controlado), parâmetros versionados, algoritmo de distância, tratamento de duplicações, indicadores agregados e documentação do ambiente. Uma implementação possível usa SQL/PostGIS, Python, PHP ou qualquer outra stack: o método não pertence a um fornecedor.
Manifesto por um IDU aberto
- Metodologia pública: fórmulas, definições, pesos e limites conhecidos.
- Replicação real: exemplos executáveis, testes e dados sintéticos publicáveis.
- Interoperabilidade: formatos abertos e independência de plataforma.
- Auditabilidade: versões, trilha de mudanças e avaliação de vieses.
- Proteção de dados: nada de publicar coordenadas residenciais ou textos capazes de reidentificar cidadãos; aplicar a LGPD e divulgar agregados seguros.
- Ciência colaborativa: estimular validações em outros territórios antes de generalizar conclusões.
- Prioridade humana: a métrica auxilia a decisão, mas nunca substitui julgamento técnico, direitos e necessidades urgentes.
A abertura da metodologia proposta neste artigo não deve ser confundida com declaração de que todo o código e os dados operacionais já estão sob licença aberta. Para uma liberação formal, será necessário escolher licença, organizar repositório, remover informações sensíveis e estabelecer regras de contribuição.
Conclusão
A pergunta original permanece útil justamente porque não admite resposta automática. Dez reclamações concentradas podem sinalizar uma prioridade maior do que trinta dispersas, mas isso precisa ser confrontado com gravidade, contexto e evidência de campo.
A contribuição que o IDU busca oferecer é uma maneira replicável e examinável de fazer essa pergunta aos dados. Para mim, a modernização da gestão pública deve significar mais do que digitalizar protocolos: deve tornar o território legível sem reduzir as pessoas a números.
Referências para aprofundamento
- TOBLER, W. R. (1970). A Computer Movie Simulating Urban Growth in the Detroit Region. Economic Geography, 46, 234–240. Referência bibliográfica.
- ANSELIN, L. (1995). Local Indicators of Spatial Association—LISA. Geographical Analysis, 27(2), 93–115. https://doi.org/10.1111/j.1538-4632.1995.tb00338.x
- ESTER, M.; KRIEGEL, H.-P.; SANDER, J.; XU, X. (1996). A Density-Based Algorithm for Discovering Clusters in Large Spatial Databases with Noise. KDD-96. Artigo original.
- SILVERMAN, B. W. (1986). Density Estimation for Statistics and Data Analysis. Chapman and Hall. https://doi.org/10.1007/978-1-4899-3324-9
Nota metodológica: a simulação é ilustrativa; nenhuma estimativa de impacto municipal ou validação estatística foi reivindicada.